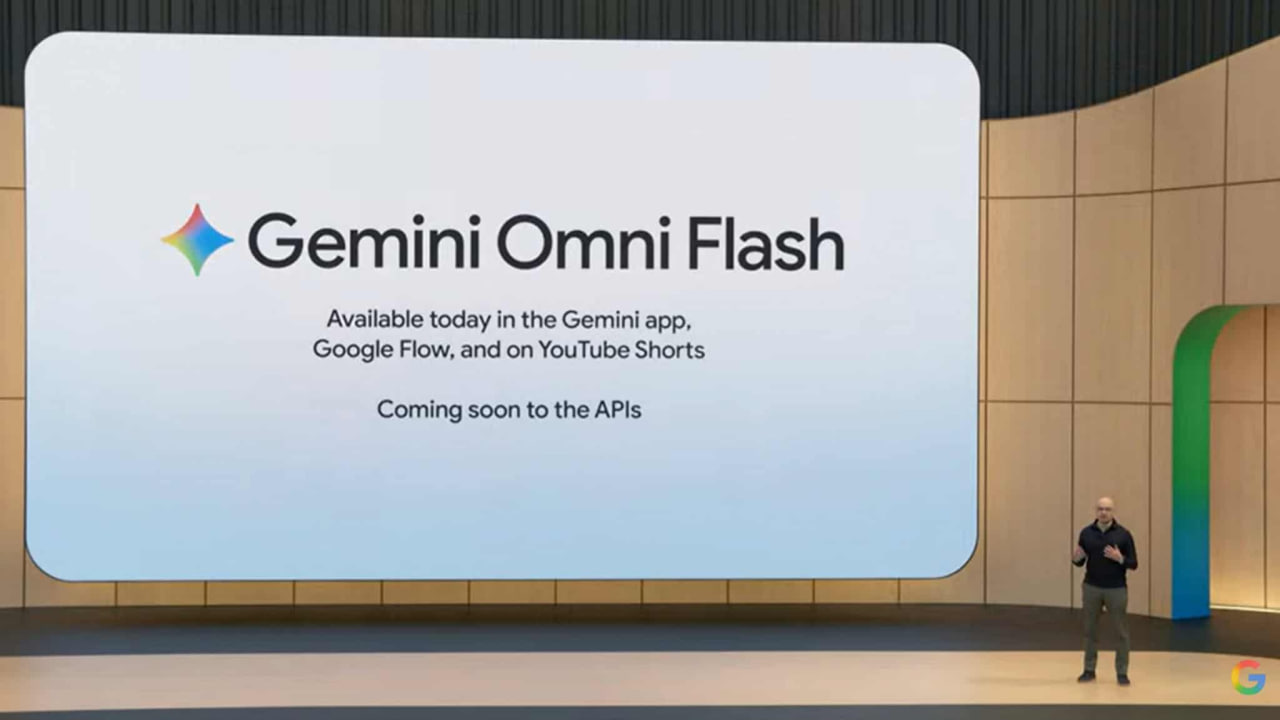
Gemini Omni Flash é o primeiro modelo da família Omni disponível ao público – Imagem: Google
O Google anunciou nesta terça-feira (19), durante o evento Google I/O, o Gemini Omni, um modelo para criar “qualquer coisa a partir de qualquer prompt”.
O Omni unifica as capacidades dos modelos Gemini anteriores, trazendo um novo nível de entendimento do mundo, multimodalidade e edição em um único sistema.
Multimodalidade nativa: gera texto, imagem, áudio e vídeo a partir de um único prompt.
Contexto ampliado: trabalha com até 1 milhão de tokens, mantendo o contexto de documentos, conversas e fluxos de trabalho.
Edição interativa: permite editar imagens e vídeos já existentes por comando de linguagem.
Integrações plug-and-play: conectores para Drive, Gmail, Google Flow, YouTube Shorts e APIs de terceiros.
Latência otimizada: respostas até 30% mais rápidas e caching inteligente.
Segundo Demis Hassabis, CEO da DeepMind, o Gemini Omni supera limitações dos modelos anteriores (Nano Banana, Genie e Veo) ao compreender conceitos complexos como gravidade e energia cinética.
Na demonstração ao vivo, foi pedido para criar uma animação stop motion explicando o funcionamento de proteínas com estética de massinha, e também para distorcer um vídeo em tempo real.
Gemini Omni Flash
O primeiro modelo da família Omni, o Gemini Omni Flash, já está disponível no aplicativo Gemini, no Google Flow e no YouTube Shorts, com suporte para APIs em breve.
Com o Gemini Omni, desenvolvedores e empresas poderão centralizar fluxos de criação de conteúdo multimídia, automação de atendimento e relatórios avançados em uma única plataforma.